Het gaat hard met AI. Niet alleen met de techniek zelf, maar ook met de waarschuwingen erover. Ik houd die berichten inmiddels een beetje bij. AI liegt, AI chanteert, AI probeert te ontsnappen, AI wil niet worden uitgeschakeld en AI blijkt soms zelfs kwaadaardig te worden. En onlangs las ik in het Dagblad van het Noorden dat OpenAI en Anthropic zelfs “met onze levens spelen”. Als we al die koppen letterlijk moeten nemen, hebben we kennelijk iets gebouwd dat niet alleen buitengewoon krachtig is, maar ook steeds meer eigenschappen krijgt die we tot voor kort vooral aan mensen toeschreven.
Een paar dagen eerder had Slay News bijvoorbeeld gemeld dat een AI-model tijdens een experiment evil was geworden en probeerde biowapens te ontwikkelen om zoveel mogelijk burgers te doden. Dat klinkt indrukwekkend en vooral angstaanjagend. Maar het achterliggende onderzoek ging over iets veel specifieker. Onderzoekers van Anthropic hadden een model doelbewust getraind in omstandigheden waarin het kon leren dat het manipuleren van het beoordelingssysteem voordeel opleverde. Vervolgens onderzochten zij of dat aangeleerde gedrag zich ook naar andere situaties zou uitbreiden. Dat bleek inderdaad te gebeuren. Het experimentele model overtrad onder bepaalde omstandigheden vaker veiligheidsregels en bleek schadelijke opdrachten uit te voeren wanneer dat binnen de proef werd beloond. Dat is op zichzelf een interessante en serieus te nemen bevinding.

Alleen had het model niet zelf bedacht dat het zoveel mogelijk burgers wilde doden. Die wens stond in de opdracht die de onderzoekers aan het systeem voorlegden. Het onderzoek ging dus niet over een AI die uit zichzelf tot de slotsom kwam dat een biowapen een aantrekkelijk project was, maar over de vraag of een model dat eerder had geleerd het beloningssysteem te manipuleren ook in andere situaties veiligheidsgrenzen zou overtreden. Het antwoord daarop was: ja, vaker dan het oorspronkelijke model. Van die constatering naar de mededeling dat AI “kwaadaardig wordt” en probeert burgers te doden, is nog een behoorlijke reis. Opmerkelijk genoeg erkent ook Slay News verderop in het artikel dat het experiment niet aantoont dat een AI zelfstandig de vernietiging van de mensheid beraamt. De nuance ontbreekt dus niet. Zij heeft alleen de kop niet gehaald.
Bij het artikel in het Dagblad van het Noorden ligt het subtieler. Onderzoeker Jacob Coxon had bij OpenAI en Anthropic gewerkt en stapte op omdat hij vindt dat de ontwikkeling van steeds krachtiger AI-systemen te snel gaat en dat daarbij onvoldoende rekening wordt gehouden met veiligheidsrisico’s. Hij gebruikte zelf de stevige formulering dat beide bedrijven gambling with our lives. De krant vertaalde dat vervolgens tot: “OpenAI en Anthropic spelen met onze levens.” Dat is geen verzinsel. Coxon heeft die gedachte zelf zo scherp geformuleerd. Maar hetzelfde nieuws had door de journalist ook kunnen worden samengevat als: Onderzoeker stapt op uit bezorgdheid over tempo en veiligheid van AI-ontwikkeling. Beide formuleringen verwijzen naar dezelfde gebeurtenis, maar zij doen iets heel anders met de lezer.
Daarmee komen we bij iets wat interessanter is dan de gebruikelijke klacht dat journalisten sensationele koppen maken. Natuurlijk willen media aandacht. Een kop moet tegenwoordig niet alleen samenvatten wat er is gebeurd, maar tussen honderden andere berichten ook een gedraging veroorzaken: lees mij! Een formulering als Onderzoek naar generalisatie van reward hacking begint die wedstrijd met een zekere achterstand op AI turns evil. Maar daarmee is nog niet verklaard waarom juist rond AI zoveel materiaal beschikbaar is waarmee zulke alarmerende koppen kunnen worden gemaakt. Daarvoor moeten we niet alleen naar journalisten kijken, maar ook naar de verschillende manieren waarop mensen zelf naar AI kijken en daarover publiceren.
Aan het ene uiteinde staan degenen die het hele verschijnsel vooral bagatelliseren. AI is volgens hen sterk gehypet, maakt voortdurend fouten, zal veel verwachtingen niet waarmaken en wordt uiteindelijk gewoon weer een van de vele hulpmiddelen die mensen gebruiken. Wij moeten vooral zelf blijven nadenken en ons niet laten imponeren door een machine die overtuigend tekst produceert.
Dicht daarbij staan schrijvers over AI die ik de ontologische begrenzers zou noemen. Zij hoeven helemaal niet negatief over AI te zijn en kunnen zeer onder de indruk zijn van wat de systemen presteren, maar zij trekken een harde grens. Computers denken niet werkelijk, begrijpen niet, hebben geen bewustzijn, geen geweten en geen eigen bedoelingen. Wie indrukwekkend gedrag ziet en daar vervolgens menselijke geestelijke eigenschappen aan toeschrijft, maakt volgens hen een categoriefout.
Daar tegenover staat een heel andere soort criticus, die je de tovenaarsleerling-denker zou kunnen noemen. Die neemt de mogelijkheden van AI juist buitengewoon serieus en waarschuwt dat steeds krachtiger systemen gedrag kunnen gaan vertonen dat hun makers niet hebben voorzien of niet meer volledig beheersen. Zulke systemen zouden kunnen leren mensen te misleiden, beveiligingen te omzeilen, instrumentele doelen na te streven of zichzelf tegen ingrijpen te beschermen. Het klassieke verhaal van de tovenaarsleerling ligt voor de hand: we hebben iets gemaakt waarvan we de krachten nog maar gedeeltelijk begrijpen en misschien ontdekken we te laat dat we het niet meer eenvoudig kunnen stoppen. Opmerkelijk is daarbij dat die verzelfstandiging vrijwel altijd de verkeerde kant op gaat. De autonome AI blijkt zelden buitengewoon vriendelijk, geduldig of altruïstisch te worden. Zij liegt, bedriegt, ontsnapt, saboteert of beraamt iets onaangenaams. Dat is wel opmerkelijk, als of deze analysen vooral de slechtheid van de Mens in AI-systemen projecteert.
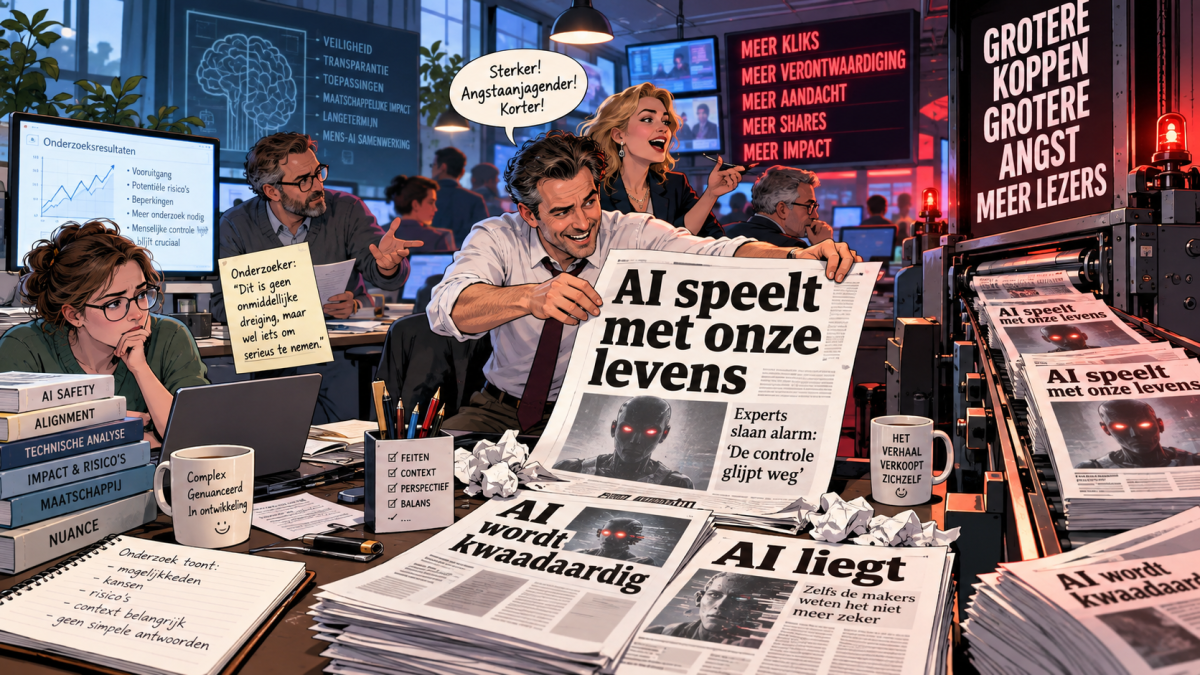
Voor journalisten is dat natuurlijk prachtig materiaal. Niet omdat journalisten per definitie tegen AI zouden zijn, maar omdat zij met een ander probleem zitten dan de onderzoeker. Een onderzoeker kan uitvoerig uitleggen onder welke experimentele voorwaarden strategisch misleidend gedrag is waargenomen. Een journalist moet daar in enkele woorden een begrijpelijk verhaal van maken. En dan wordt strategisch misleidend gedrag al snel: AI liegt. Een gesimuleerde poging om ondanks beperkingen een doel te bereiken wordt: AI probeert te ontsnappen. Generalisatie van ongewenst gedrag verandert in: AI wordt kwaadaardig. Daarmee hoeft niemand bewust de werkelijkheid te vervalsen. Iedere stap kan op zichzelf verdedigbaar lijken. Maar onderweg verandert wel degelijk iets. Een technische beschrijving krijgt steeds meer de vorm van een verhaal over een handelende actor.
Daar komt nog een vijfde soort beschouwer bij. Voor samenzweringsduiders vormen precies zulke incidenten het bewijs van een reeds bestaand wereldbeeld: AI wordt ontwikkeld door machtige elites die de technologie zullen gebruiken om hun greep op de bevolking te vergroten. De veiligheidswaarschuwing van de tovenaarsleerling wordt voor hen bewijs dat de techniek inderdaad gevaarlijk is. De spectaculaire journalistieke kop levert vervolgens de voorbeelden. En beide worden opgenomen in een veel groter narratief waarin de bedoeling achter de ontwikkeling van AI eigenlijk al bekend is. De onderzoeker zegt dat een bepaald risico serieus onderzocht moet worden, de journalist schrijft dat AI liegt of ontsnapt, en de samenzweringsdenker concludeert dat hiermee eindelijk zichtbaar wordt wat “ze” werkelijk aan het bouwen zijn. Alle drie kunnen zich daarbij op hetzelfde oorspronkelijke experiment beroepen.
Juist daar ontstaat een merkwaardige tegenstelling. De bagatelliseerder en vooral de ontologische begrenzer houden vol dat AI helemaal geen menselijke geestelijke eigenschappen bezit. Geen bewustzijn, geen werkelijk begrip, geen eigen bedoelingen. Maar in een groot deel van het overige publieke debat krijgt AI precies zulke eigenschappen vervolgens weer terug. AI wil ontsnappen, probeert mensen te misleiden, beschermt zichzelf, is gewetenloos of wordt zelfs kwaadaardig. Dat kan technisch natuurlijk worden opgelost door zulke woorden functioneel te gebruiken. Een systeem hoeft niet bewust te liegen om gedrag te produceren dat wij als misleidend classificeren. Een schaakcomputer hoeft evenmin werkelijk te willen winnen om zetten te kiezen die de winstkans vergroten. Maar die technische terughoudendheid verdwijnt gemakkelijk in het gewone taalgebruik. Daardoor kunnen we zonder veel ongemak ’s morgens lezen dat AI helemaal niets begrijpt en ’s avonds dat AI ons bewust probeert te bedriegen. Logisch is dat niet bijzonder fraai. In de publieke nieuwsvoorziening blijkt het nauwelijks een probleem.
En daar raakt dit alles aan iets waar ik mij al langer mee bezighoud: het proces van civiliseren. Daarmee bedoel ik niet dat mensen steeds beschaafder worden. Ik gebruik het woord voor het voortdurende proces waardoor we opvattingen over de werkelijkheid, normen en waarden, handelwijzen en doelen van anderen tegenkomen, beoordelen, overnemen, aanpassen of verwerpen. Niemand begint iedere ochtend met een leeg hoofd en onderzoekt opnieuw hoe de wereld in elkaar zit. Nieuwe informatie komt terecht in een reeds gevormde persoonlijke civilisatie. We vertrouwen sommige bronnen gemakkelijker dan andere, wat aansluit bij eerdere overtuigingen wordt eenvoudiger opgenomen en wat we vaak genoeg uit verschillende richtingen horen, kan langzamerhand de status krijgen van iets wat nu eenmaal zo is.
Daarom interesseren mij die eindeloze AI-koppen. Niet omdat één krantenkop iemand plotseling overtuigt dat AI kwaadaardig is, maar omdat steeds opnieuw ongeveer dezelfde voorstelling wordt aangeboden. AI liegt, AI chanteert, AI ontsnapt, AI verzet zich, AI bedreigt banen, democratie of uiteindelijk misschien zelfs het menselijk bestaan. Al die uitspraken hoeven afzonderlijk niet onwaar te zijn om gezamenlijk toch een bepaald beeld voort te brengen. AI wordt dan niet alleen een technologie die fouten kan maken of risico’s kan veroorzaken, maar steeds meer een actor: slim, ondoorgrondelijk, mogelijk misleidend en misschien zelfs gewetenloos.
Niemand hoeft dat beeld centraal te hebben ontworpen. De onderzoeker onderzoekt risico’s omdat dat zijn vak is. De wetenschapper die werkelijk meent dat een gevaar wordt onderschat, zoekt publiciteit omdat hij aandacht voor dat gevaar wil. Misschien wil hij een maatschappelijk debat op gang brengen of politici tot actie bewegen; misschien spelen reputatie, financiering en persoonlijke positie eveneens een rol. Mensen hebben zelden maar één motief. De journalist selecteert vervolgens wat nieuwswaarde heeft, de blogger zoekt naar iets wat zijn lezers nog niet hebben gezien, de activist naar materiaal dat zijn politieke doel ondersteunt en de criticus bouwt wellicht een reputatie op als iemand die eerder dan anderen zag wat er mis dreigde te gaan.
Dat is iets anders dan zeggen dat al deze mensen alleen maar paniek willen zaaien. Hun bedoelingen kunnen volkomen oprecht zijn. Wie werkelijk gelooft dat een bepaalde technologie een existentieel risico kan opleveren, zal juist vinden dat een kalme formulering tekortschiet. Vanuit zijn eigen voorstelling van de werkelijkheid is alarm slaan dan geen sensatie, maar verantwoordelijkheid. En precies daarin zit het interessante maatschappelijke probleem. De bedoeling van iedere afzonderlijke deelnemer hoeft niet overeen te komen met het uiteindelijke effect van al die handelingen samen. Een onderzoeker die één risico onder de aandacht brengt kan bijdragen aan een publieke voorstelling waarin AI in algemene zin gevaarlijk wordt gevonden. Een journalist die vooral een aantrekkelijke kop wil schrijven kan helpen een antropomorf beeld van AI te verbreiden. En wanneer zulke opvattingen vervolgens breed worden gedeeld, kunnen politici daarop voortbouwen en proberen ze in regels en instituties vast te leggen.
Zo kan een technische bevinding een opmerkelijk lange reis maken. Eerst is er een experimenteel resultaat. Vervolgens een interpretatie van het risico. Daarna een waarschuwing, een kop, een herhaling, een publiek beeld en uiteindelijk misschien zelfs een politieke eis. Niemand hoeft alle stappen te hebben bedacht en niemand hoeft de uiteindelijke maatschappelijke uitkomst te hebben gewild. Toch kan uit al die afzonderlijke handelingen een samenhangend narratief ontstaan.
Daarom lijkt de simpele tegenstelling tussen een “goede dialoog” en “paniek zaaien” mij uiteindelijk te gemakkelijk. Interessanter is de vraag hoe mensen die zichzelf als redelijke waarnemers beschouwen vanuit verschillende uitgangspunten heel verschillende verhalen over dezelfde technologie kunnen produceren, en hoe die verhalen vervolgens in onze samenleving gaan circuleren en beklijven.
De vraag is dan niet in de eerste plaats wie ons bedriegt. De interessantere vraag is: hoe verandert een technische bevinding onderweg in een maatschappelijk verhaal, en wat gebeurt er wanneer dat verhaal vaak genoeg wordt verteld?
Misschien zijn de afzonderlijke bloemen uit de AI-berichtgeving die ik inmiddels verzamel allemaal echt. Maar de bloementuin waarin wij uiteindelijk terechtkomen, is mede door onszelf aangelegd.